Modellvergleich auf Kundendaten.
Das richtige Modell für Ihre Aufgabe. Mit Zahlen, die Ihre Entscheidung tragen.
Wir vergleichen drei geeignete KI-Modelle mit einem kleinen Testset aus Ihrem Alltag: Qualität, Laufzeit und Kosten. Sie erhalten eine klare Empfehlung mit Messdaten und Grenzen – unabhängig vom Modellanbieter.
Modellkenntnis aus eigener Security-Praxis: Franz Bettag entwickelt eine Bug-Bounty-Plattform mit mehreren Modellfamilien. Seine Arbeit ist öffentlich belegt: #2 VDP Researcher Deutschland, Januar–März 2026. Workflow und Nachweis ansehen
Mehr Intelligenz pro Dollar.
17 Modelle, dazu die Reasoning-Stufen von OpenAI. Wählen Sie Anbieter und Einstellungen aus und entdecken Sie Kandidaten für einen Test mit Ihren Daten.
35 Punkte im Diagramm · Preisachse bleibt unverändert
Keine Punkte für diese Auswahl.
Zahl = Modell in der Legende · Text = Reasoning-Stufe
Mehr Reasoning verändert Tokenverbrauch und Laufzeit, nicht den Tarif je Token. Deshalb stehen die Stufen eines OpenAI-Modells senkrecht übereinander. Der Preis einer gelösten Aufgabe kann trotzdem stark variieren. Astra unterstützt low bis max; none zeigen wir für Sol, Terra und Luna. Reasoning und Abrechnung.
Lineare Preisachse ab 0: Doppelt so weit rechts bedeutet doppelt so teuer. Preismix: 75 % Input + 25 % Output, ohne Cache und Batch. Die tatsächlichen Tokens pro Aufgabe unterscheiden sich je Modell. Benchmark: Artificial Analysis Intelligence Index v4.3.2. Stand: .
Qwen3.8 Flash: 0,15 USD Input / 0,47 USD Output je Mio. Tokens; noch ohne verifizierten Indexwert. Qwen führt die API-Varianten Max, Plus und Flash. Die Qwen-Preise beziehen sich auf den Tarif International.
Teurer heißt nicht stärker.Opus 5.5 führt den Index mit 58 Punkten und kostet 8 USD je Mio. Tokens im 3:1-Mix. Fable 5.1 kostet 20 USD und erreicht 53 Punkte. Der stärkste Wert ist damit 60 % günstiger als der teuerste Tarif. Sonnet 5 liegt bei 4 USD und 38 Punkten.
Der Test entscheidet.GLM-5.3 Flash liegt im selben Preismix bei rund 0,24 USD. Ob ein günstigeres Modell Ihre Aufgabe zuverlässig löst, prüfen wir mit Ihren Daten und klaren Abnahmekriterien.
Alle Tokenpreise und Ihr Monatsvolumen berechnen
Bitte ganze Zahlen ab 0 eingeben: maximal 1 Milliarde Aufgaben, 256.000 Input- und 2 Millionen Output-Tokens.
| Modell | Input | Output | Monatskosten | Quelle |
|---|---|---|---|---|
| Claude Fable 5.1 | 10.00 USD | 50.00 USD | Preisliste: Claude Fable 5.1 | |
| Claude Opus 5.5 | 4.00 USD | 20.00 USD | Preisliste: Claude Opus 5.5 | |
| Claude Opus 5 | 5.00 USD | 25.00 USD | Preisliste: Claude Opus 5 | |
| Claude Sonnet 5 | 2.00 USD | 10.00 USD | Preisliste: Claude Sonnet 5 | |
| Claude Haiku 4.5 | 1.00 USD | 5.00 USD | Preisliste: Claude Haiku 4.5 | |
| GPT-6 Astra | 10.00 USD | 50.00 USD | Preisliste: GPT-6 Astra | |
| GPT-6 Sol | 2.00 USD | 10.00 USD | Preisliste: GPT-6 Sol | |
| GPT-5.6 Terra | 2.00 USD | 12.00 USD | Preisliste: GPT-5.6 Terra | |
| GPT-6 Luna | 0.10 USD | 0.50 USD | Preisliste: GPT-6 Luna | |
| GLM-5.3 | 1.40 USD | 4.40 USD | Preisliste: GLM-5.3 | |
| GLM-5.3 Flash | 0.15 USD | 0.50 USD | Preisliste: GLM-5.3 Flash | |
| Kimi K3 | 3.00 USD | 15.00 USD | Preisliste: Kimi K3 | |
| MiniMax M3 | 0.30 USD | 1.20 USD | Preisliste: MiniMax M3 | |
| Qwen3.8 Max | 2.00 USD | 6.00 USD | Preisliste: Qwen3.8 Max | |
| Qwen3.7 Plus | 0.40 USD | 1.60 USD | Preisliste: Qwen3.7 Plus | |
| Qwen3.8 Flash | 0.15 USD | 0.47 USD | Preisliste: Qwen3.8 Flash | |
| Claude Fable 5 | 10.00 USD | 50.00 USD | Preisliste: Claude Fable 5 |
Monatskosten = Aufgaben × (Input-Tokens × Inputpreis + Output-Tokens × Outputpreis) ÷ 1.000.000. Ohne Cache, Batch, Tools, Steuern und Sonderverträge. Eine Preisrechnung, keine Modellaufrufe oder Prüfung von Modelllimits.
Tarifdetails: OpenAI weist für GPT-6 und GPT-5.6 getrennte Preise für kurzen und langen Kontext aus; wir zeigen den Tarif für kurzen Kontext. Qwen3.7 Plus zeigt den regulären Preis der Version 2026-05-26 bis 256K Input-Tokens. MiniMax M3: Standardtarif bis 512K. Größere Kontexte können teurer sein.
Gleicher Text bedeutet nicht gleiche Tokenzahl. Tokenisierung, Thinking, Antwortlänge und Wiederholungen unterscheiden sich. Im Kundentest messen wir deshalb Kosten je akzeptiertem Ergebnis mit den tatsächlich abgerechneten Tokens. Der allgemeine Benchmark ersetzt diese Prüfung nicht.
Modellkenntnis aus echter Security-Arbeit.
Recherche. Gegenprüfung. Belastbare Belege. Genau dort lernen wir die Stärken und Fehlergrenzen von Modellen kennen.
#2
VDP Researcher Deutschland
HackerOne · Januar–März 2026
Franz Bettags eigene Bug-Bounty-Plattform verbindet spezialisierte Agenten mit getrennten Recherche- und Prüfphasen. Die Konfiguration umfasst sechs Modellfamilien: OpenAI, Claude, GLM, Kimi, MiniMax und DeepSeek. Das Modellprofil lässt sich je Phase wählen.
Diese Praxis fließt in Ihren Vergleich ein: Aufgaben sinnvoll aufteilen, Ergebnisse gegenprüfen und Fehlversuche mitbewerten.
Ergänzend dokumentieren die Anthropic-Kurszertifikate die Weiterbildung zu Claude, APIs und Agenten. Kursnachweise ansehen
Die Bug-Bounty-Fallstudie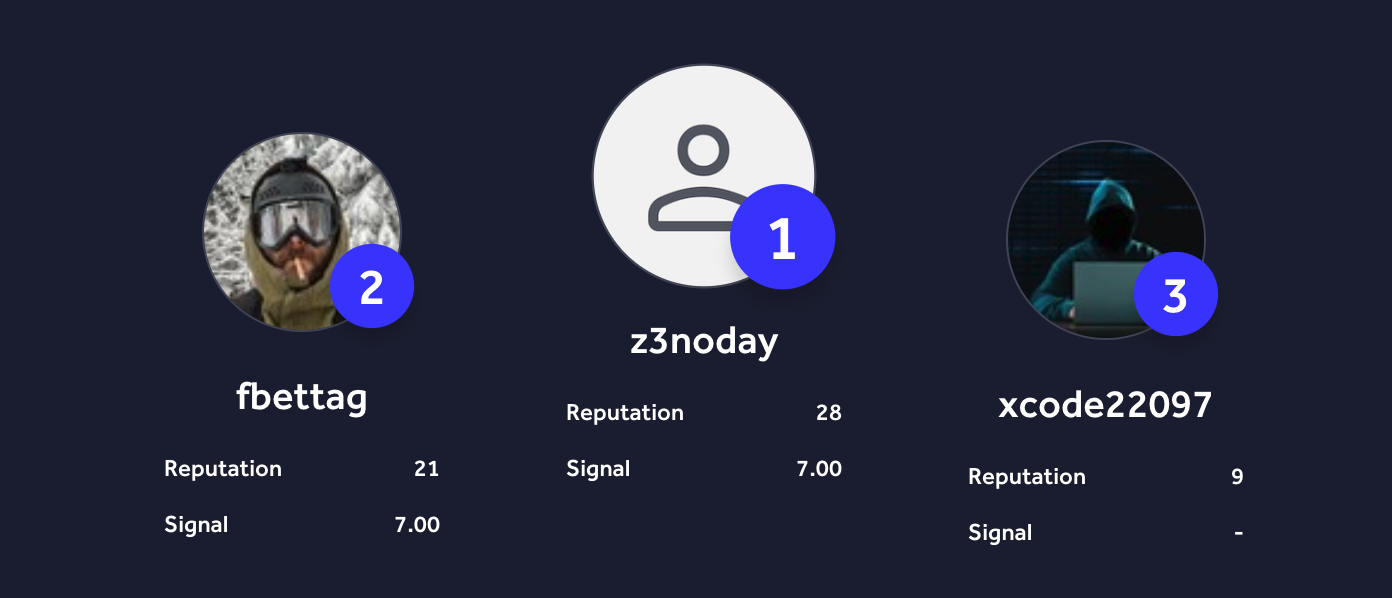
Kleines Testset. Belastbare Entscheidung.
Ein abgegrenzter Anwendungsfall reicht für den Einstieg: etwa Support-Antworten, Dokumentenextraktion, Klassifikation oder Zusammenfassungen. Wir testen, was Ihr Betrieb tatsächlich braucht.
-
1
Aufgabe und Abnahme festlegen
Typischer Start: 30–50 repräsentative Beispiele inklusive Randfällen, Referenzantworten und klarer Bewertungsrubrik. Unsere Security-Erfahrung hilft, gezielt auch widersprüchliche Anweisungen und manipulierte Inhalte als Testfälle einzubeziehen, wo sie für Ihre Anwendung relevant sind. Auswahl und Umfang vereinbaren wir vorab.
-
2
Drei Modelle auswählen
Passend zu Aufgabe, Sprache, Datenfreigabe und Budget. Ihr heutiges Modell kann die Baseline sein. Die Auswahl erfolgt anbieterneutral; ein günstiger Kandidat muss fachlich geeignet sein.
-
3
Vergleichbar messen
Gleiches Testset und gleiche Abnahmekriterien. Wir protokollieren Modellversion, Prompt, Einstellungen, Wiederholungen und Fehler. Ein separater Prüfsatz verhindert Optimierung nur auf bekannte Beispiele.
-
4
Entscheidung übergeben
Empfehlung mit Begründung, Kostenhochrechnung, Fehlerbeispielen und Grenzen. Wechseln, gezielt kombinieren oder beim bisherigen Modell bleiben: Das Ergebnis ist offen.
Ihre Entscheidungsvorlage.
Verständlich für die Geschäftsführung. Nachprüfbar für Ihr Engineering-Team.
Die Evaluation wird als eigenständige Leistung angeboten. Festpreis nach Sichtung von Aufgabe und Testset; Umfang, API-Budget und Liefertermin werden vor Beauftragung festgehalten. Eine anschließende Umsetzung ist optional.
Testvorhaben besprechen- Qualität und Fehler
- Erfolgsquote mit Zähler und Nenner, Bewertung nach Rubrik und konkrete Fehlertypen. Fachliche Prüfung der Antworten; ein LLM-Judge ist höchstens unterstützend. Unsere Erfahrung aus der Cybersecurity hilft, beobachtete Schwächen und ihre Folgen für Ihren Einsatz einzuordnen.
- Laufzeit und Stabilität
- Ende-zu-Ende-Laufzeiten als Median und Streuung, Timeouts und Wiederholungen. Tail-Latenzen nur mit ausgewiesener Stichprobe und ausreichender Messbasis.
- Kosten und Wirtschaftlichkeit
- Input, Output, Cache und berechnetes Thinking gemäß Usage-Daten; Tools und Fehlversuche separat. Gesamtkosten geteilt durch akzeptierte Ergebnisse. Bei null Treffern: kein sinnvoller Stückpreis.
- Prüfbare Unterlagen
- Kompakte Entscheidungsvorlage, Vergleichstabelle als CSV, Testprotokoll und versionierte Konfiguration. Dazu eine Ergebnisbesprechung mit konkreten nächsten Schritten.
Vor dem ersten Test geklärt.
Anbieterneutral bedeutet: Die Anforderungen führen die Auswahl. Auch wenn wir mit einzelnen Anbietern zusammenarbeiten, entscheidet Ihr Testset über die Empfehlung.
Was passiert mit unseren Daten?
Wir vereinbaren zulässige Testdaten, Empfänger, Aufbewahrung und Löschung vor dem Start. Vertrauliche Inhalte werden nur in einer von Ihnen freigegebenen Umgebung verarbeitet. Für die erste Anfrage genügt eine Beschreibung ohne Kundendaten.
Sind Einsparungen garantiert?
Nein. Ein günstigeres Modell kann mehr Tokens oder Versuche brauchen oder an der Qualität scheitern. Wir rechnen mit Ihrem Volumen und berücksichtigen Wechselaufwand. Der Test kann auch bestätigen, dass Fable oder Opus für Ihre Aufgabe die wirtschaftlichere Wahl bleibt.
Wie aussagekräftig ist ein kleines Testset?
Es liefert eine erste Entscheidungsgrundlage für den abgegrenzten Anwendungsfall. Wir dokumentieren Stichprobe, Schwankungen und nicht getestete Fälle. Für seltene Fehler oder weitreichende Produktionsentscheidungen kann eine größere Folgemessung nötig sein.
Welches Modell passt zu Ihren Daten?
Wir definieren gemeinsam Testfälle, Qualitätsmaßstäbe und Betriebsgrenzen für Ihren Anwendungsfall.
Modellvergleich für Ihr Projekt besprechen